研究論文|理論模型與實證方案
單人排位中的開團跟隨決策
均勢條件下“先跟、再判斷”的動態協調博弈
——均勢條件下“先跟、再判斷”的動態協調原則——
2026年8月
摘要
在多人線上戰術競技(MOBA)遊戲的單人排位中,一名隊友先手開團後,其餘玩家面對的首要問題並不是立即決定是否投入全部技能,而是是否應立刻朝戰場響應。本文提出“均勢域先跟原則”:當雙方可參戰人數沒有懸殊差距、團隊經濟差距沒有超出預設閾值,且響應者能在有效視窗內到場時,理性玩家的預設動作應是先跟進,再依新資訊選擇全力承諾、有限支援或退出。本文構建一個兩階段動態不完全資訊協調博弈。第一階段的“先跟”是移動、靠近、掩護或施放可回撤的低成本技能,其價值來自保留後續行動選項、避免響應時延造成不可逆損失,並向隊友與敵方傳遞可觀察的支援訊號;第二階段才決定承諾強度。模型證明:在均勢域內,只要保留選項、救援與協調乘數的最低收益不低於初始響應成本,先跟在該條件域內構成弱佔優策略,並在嚴格不等式成立時成為唯一最佳反應。策略互補進一步使早期跟進提高其他隊友跟進的機率,將團隊由低響應均衡推向高響應均衡。由於等待會縮小控制鏈、集火和救援視窗,“原地觀察後再決定”通常比“先跟後判斷”損失更多選項。本文同時說明,先跟不等於盲目全壓;當後續資訊顯示人數或經濟已轉為懸殊、敵方增援出現、或自身投入不再具有邊際價值時,玩家仍應轉為有限支援或退出。本文據此提出可檢驗假說與事件級因果識別方案。核心結論是:均勢時先跟是一項條件明確的協調原則,後續承諾強度則應隨局勢更新。
關鍵詞:MOBA;單人排位;先跟原則;協調博弈;選項價值;策略互補;響應時延
JEL分類號:C72,C73,D82,D91
Abstract
This paper develops a dynamic coordination-game foundation for a follow-first rule in solo-queue multiplayer online battle arena games. The rule applies to a balanced domain in which neither team has an overwhelming numerical advantage, the economy gap remains within a pre-specified bound, and the responder can arrive within the effective combat window. Decisions occur in two stages. A responder first takes a low-cost, reversible action toward the engagement, thereby preserving the option to contribute, reducing irreversible delay loss, and sending a visible coordination signal. After observing additional information, the responder chooses full commitment, limited support, or disengagement. The model shows that following first is weakly dominant within the balanced domain whenever the lower bound of option-preservation, rescue, and coordination benefits covers the initial response cost; it is uniquely optimal under a strict inequality. Strategic complementarities amplify early visible support and can shift the team from a low-response to a high-response equilibrium. Waiting may provide information, but it destroys action options when combat effectiveness decays faster than useful information arrives. The rule does not require blind all-in play: commitment intensity remains state-contingent after the initial response. The paper derives testable hypotheses and an event-level causal design for telemetry or replay data.
Keywords: MOBA; solo queue; follow-first rule; coordination game; option value; strategic complementarity; response latency
1 引言
單人排位中的開團響應不是一個靜態的“勇敢或怯懦”選擇,而是一個在數秒內完成的分散式團隊決策。開團者首先暴露位置並消耗技能;其餘玩家分別觀察到不同的小地圖、血量、技能冷卻與敵方動向,並同時推測“別人會不會來”。這使決策同時具備四個特徵:行動順序、私人資訊、策略相互依賴與時間衰減。任何只比較“5對5”和“4對5”的收益矩陣都遺漏了最關鍵的內生變數——響應人數本身由每位玩家對其他人的信念共同決定。
本文研究的不是“任何局勢都盲目跟團”,而是一個邊界清楚的強命題:當雙方可參戰人數差不多、團隊經濟相差不大,且玩家能在有效時間內到場時,隊友一旦開團,預設反應應是先跟進,而不是站在原地等待結果變得明朗。先跟是朝戰場移動、靠近可支援位置、提供掩護或使用可回撤的低成本技能;它與交出全部位移和關鍵技能的全壓承諾不同。
“先跟、再看”利用了兩種不對稱。第一,先靠近後仍可根據敵方增援、技能命中與隊友路徑改為有限支援或退出;但原地等待後失去的到場時間通常無法追回。第二,一名玩家的早期跟進會提高其他隊友相信“大家都會到”的機率,產生協調乘數;不跟則可能把原本可打的均勢團自我實現地變成少打多。
本文有四項貢獻。第一,正式定義由人數差、經濟差與可達性構成的均勢域,並推導域內的先跟原則。第二,把響應拆成“初始跟進”與“後續承諾”兩階段,從而說明先跟並不等於盲目全壓。第三,把選項保留、策略互補、訊號與時延衰減放進同一動態博弈,解釋為何先跟後判斷通常優於先觀察後行動。第四,提出可複製的事件定義、預測假說與因果估計策略。
核心結論 在雙方人數與經濟均無懸殊差距、且能有效到場時,隊友開團後應先跟進;跟進途中再依新增資訊決定全力承諾、有限支援或退出。先跟是預設起手式,不是不可撤回的全壓指令。 |
2 文獻基礎與理論缺口
2.1 臨時團隊與電競協調
MOBA單排隊伍屬於典型的臨時團隊:成員缺乏共同歷史,卻必須在短時高壓環境中協作。Kou與Gui(2014)對《英雄聯盟》玩家的訪談顯示,陌生人團隊仍會透過溝通、角色履行與相互影響建立臨時協作;Freeman與Wohn(2018)進一步強調電競團隊在壓力下依賴多模態溝通、狀態同步與動態角色調整。Kahn與Williams(2016)結合18,627名玩家調查與伺服器資料,發現互動記憶系統與勝負顯著相關,說明“誰知道什麼、誰能做什麼”的共享認知本身具有績效價值。
這些研究支援本文的基本機制:臨時隊伍即使缺乏共同歷史,也能透過可觀察的早期動作建立共同預期。團隊組成則會改變先跟之後的最佳承諾強度。Cheng等(2019)使用《王者榮耀》9,600萬場比賽的資料發現,角色多樣性與勝率、韌性及失利時的互動行為相關。這意味著坦克、輔助與輸出位都可以遵循先跟原則,但其後採取的承傷、保護或輸出方式不能用同一個固定成本表示。Sapienza等(2018)還發現連續遊戲過程中的個體表現會變化,提醒模型納入疲勞、經驗和局內狀態。
2.2 協調博弈、不完全資訊與策略互補
Schelling(1960)的聚焦點概念解釋了無溝通團隊為何會依賴顯著行動作為共同參照;Harsanyi(1967)則提供了把私人資訊與型別納入貝葉斯博弈的基礎。Cooper與John(1988)指出,策略互補會使個體最佳反應隨他人行動增加,從而產生協調失敗和多重均衡。Morris與Shin(2003)的全球博弈研究表明,即使基本面相同,玩家關於他人信念的信念也會影響均衡選擇。開團響應正是一個高階信念極為重要的微型場景。
然而,純粹的“獵鹿博弈”仍然過於粗糙。MOBA團戰不是達到固定人數就必然成功的公共品,而是一個成功機率隨角色、位置、技能與時點連續變化的團隊生產過程;參與者也不是隻能選擇0或1,而可用前壓、遠端消耗、護盾、拆火或撤退形成連續支援強度。因此本文以機率生產函式為基礎,再把二元模型擴充套件為三元與連續行動。
2.3 有限理性與行為偏誤
現實玩家會受損失厭惡、歸因偏誤、KDA保護和情緒影響。前景理論說明個體對損失與機率的主觀權重並非線性(Kahneman & Tversky, 1979);量化反應均衡則允許較高效用行動被更高機率選擇,而不要求每次都完美最優(McKelvey & Palfrey, 1995)。這些機制適合解釋同一玩家在相似狀態下仍會作出不同響應。
必須特別澄清沉沒成本。開團者已經交出的位移或閃現本身不能成為其他玩家全壓的理由(Arkes & Blumer, 1985);但開團者此後的存活機率、敵方是否追擊、控制鏈能否銜接以及團隊未來合作都仍是可被當前行動改變的前瞻結果。因此,先跟原則不是“隊友已經付出所以我也要付出”,而是“我的即時靠近仍能保留救援、反打與協調選項”。已消耗的資源是沉沒成本,尚可改變的未來結果不是。
3 場景、時序與符號
3.1 事件邊界
本文把“開團事件”定義為:己方玩家A在時間t₀首先採取顯著提高雙方短期交戰機率的不可逆行動,例如進入敵方控制/傷害範圍、命中硬控、使用強制位移或承擔防禦塔與多人火力。普通試探性技能、遠端清線與無後續接觸的視野動作不計入。響應視窗為[t₀, t₀+T];T應依遊戲節奏和技能持續時間在資料中預註冊,而不能在看到結果後調整。
參與者為開團者A、n=4名潛在響應者i∈N以及敵方E。自然先抽取基本面θ,包括雙方經濟、可參戰人數、等級、血量、關鍵技能、站位、視野、陣容、地圖目標與復活時間。本文預先給定人數差上限n̄與相對經濟差上限ḡ,將同時滿足|ΔN|≤n̄、|ΔG|≤ḡ且i可在視窗內到場的狀態定義為均勢域Θᴮ。A觀察私人訊號s_A並開團後,i先選擇是否立即跟進xᵢ∈{0,1};隨新增資訊到達,再從全力承諾F、有限支援S與退出R中選擇第二階段行動。敵方則根據可見支援選擇追擊、接戰或撤退。
為使“差不多”可以被檢驗,實證基準規格可預註冊為:可參戰人數差不超過1人,且團隊總經濟差的絕對值不超過雙方平均經濟的10%。這只是待驗證的起始界線,不冒充已知遊戲常數;穩健性分析應同時報告0/1人人數差及5%、10%、15%經濟差門檻,檢查先跟效果是否在接近懸殊區時衰減。
3.2 核心符號
表1 模型符號與經驗對應
符號 | 定義 | 可觀測代理 |
θ | 團戰基本面或潛在質量狀態 | 經濟差、人數差、等級差、血量、技能、站位、視野與目標價值 |
Θᴮ | 人數、經濟與可達性均未失衡的均勢域 | |ΔN|≤n̄、|ΔG|≤ḡ且能在響應視窗內生效 |
xᵢ | 響應者i是否立即採取初始跟進,取0或1 | 朝戰場移動、靠近、掩護、低成本技能與可見轉向 |
z | 除i以外隊友的有效支援總量 | 按到場時延和角色權重摺算的支援量 |
q(z,θ) | 己方在該事件中獲得有利結果的機率 | 淨擊殺、淨經濟、目標控制或勝率變化 |
Bᵢ | 有利結果對i的延續價值 | 事件後預測勝率的貨幣化/效用化變化 |
cᵢ | i初始跟進的邊際成本 | 路徑偏移、低成本技能、短暫暴露與放棄原路線的機會成本 |
πᵢ | i對有利基本面的後驗信念 | 由公共狀態、私人視野及開團動作更新 |
τᵢ | 到場或生效時延 | tᵢ−t₀ |
λ | 戰鬥視窗的衰減率 | 控制鏈、集火機會與救援機率隨時間下降的速度 |
δ | 局內未來互動的折現因子 | 剩餘時長、復活週期與目標價值 |
4 均勢域中的先跟基準模型
4.1 初始響應效用與條件域
先假設θ與其他人的支援量z為共同知識,並把分析限制在均勢域Θᴮ。響應者i在原地等待時得到Uᵢ(0,z,θ),立即採取可回撤的初始跟進時得到Uᵢ(1,z,θ)。此處xᵢ=1不是全壓,而是能保留後續參戰選項並向他人顯示響應的最小有效動作。將效用拆成對局延續價值、即時協調與選項收益、以及初始跟進成本:
(1)
其中Bᵢ是事件對最終排位目標的延續價值;令初始跟進的額外收益Δrᵢ=Oᵢ(τᵢ)+Kᵢ(z)+Wᵢ(θ):Oᵢ是保留到場與後續選擇的選項價值,Kᵢ是可觀察跟進引發的協調收益,Wᵢ是救援與威懾收益;cᵢ只計算立即轉向、靠近或低成本支援尚未發生的邊際成本。由式(1),先跟相對原地等待的效用差為:
(2)
最優反應為xᵢ*=1,當且僅當ΔUᵢ≥0。均勢域的作用是排除人數或經濟已使邊際成功機率接近零的懸殊狀態;兩階段結構則使cᵢ只對應可回撤的初始響應,而不是一次性交出全部資源。由於先跟能保存到場選項,原地等待所失去的時間通常不可逆,而先跟後仍能降低承諾強度。
命題1(均勢域先跟原則)。在Θᴮ內,若對所有可行θ與z均有Bᵢ[q(z+1,θ)−q(z,θ)]+Δrᵢ(z,θ)≥cᵢ,則xᵢ=1在均勢域內弱佔優於原地等待;若至少一個可行狀態嚴格大於且其餘狀態不等式不反轉,則先跟為嚴格最佳反應。換言之,只要保留選項、救援與協調的最低收益足以覆蓋初始跟進成本,理性預設就是先跟,再根據後續資訊調整承諾。
這一命題不是把結論藏進定義,而是給出可檢驗的充分條件:n̄與ḡ界定何時排除懸殊局;到場路徑決定cᵢ;早期靠近對開團者存活、其他隊友轉向及敵方追擊的影響決定Δrᵢ;事件模型則估計q的邊際變化。完整證明見附錄A。
4.2 策略互補與多重均衡
若隊友的支援使自己的技能更容易命中、輸出環境更安全或救援更有效,則支援行動存在策略互補。形式上,在相關區間內:
(3)
式(3)表示他人的支援越多,自己的初始跟進越有價值。其來源包括前排分攤傷害、控制鏈銜接、集火速度、保護覆蓋與敵方目標選擇困難。策略互補會產生兩個自我實現的預期:若大家預期別人會先跟,轉向戰場成為最佳反應並形成高響應均衡;若大家都停下觀察,原本可打的均勢事件會因響應不足而落入低響應均衡。
為表示平滑的戰鬥生產函式,可使用邏輯成功函式:
(4)
a(θ)概括基本面,β表示有效響應對成功對數勝算的提升。邏輯函式在低成功率區間呈邊際貢獻上升,越接近臨界點,隊友之間越可能是互補品;越過拐點後邊際貢獻下降,過度投入可能轉為機會成本。
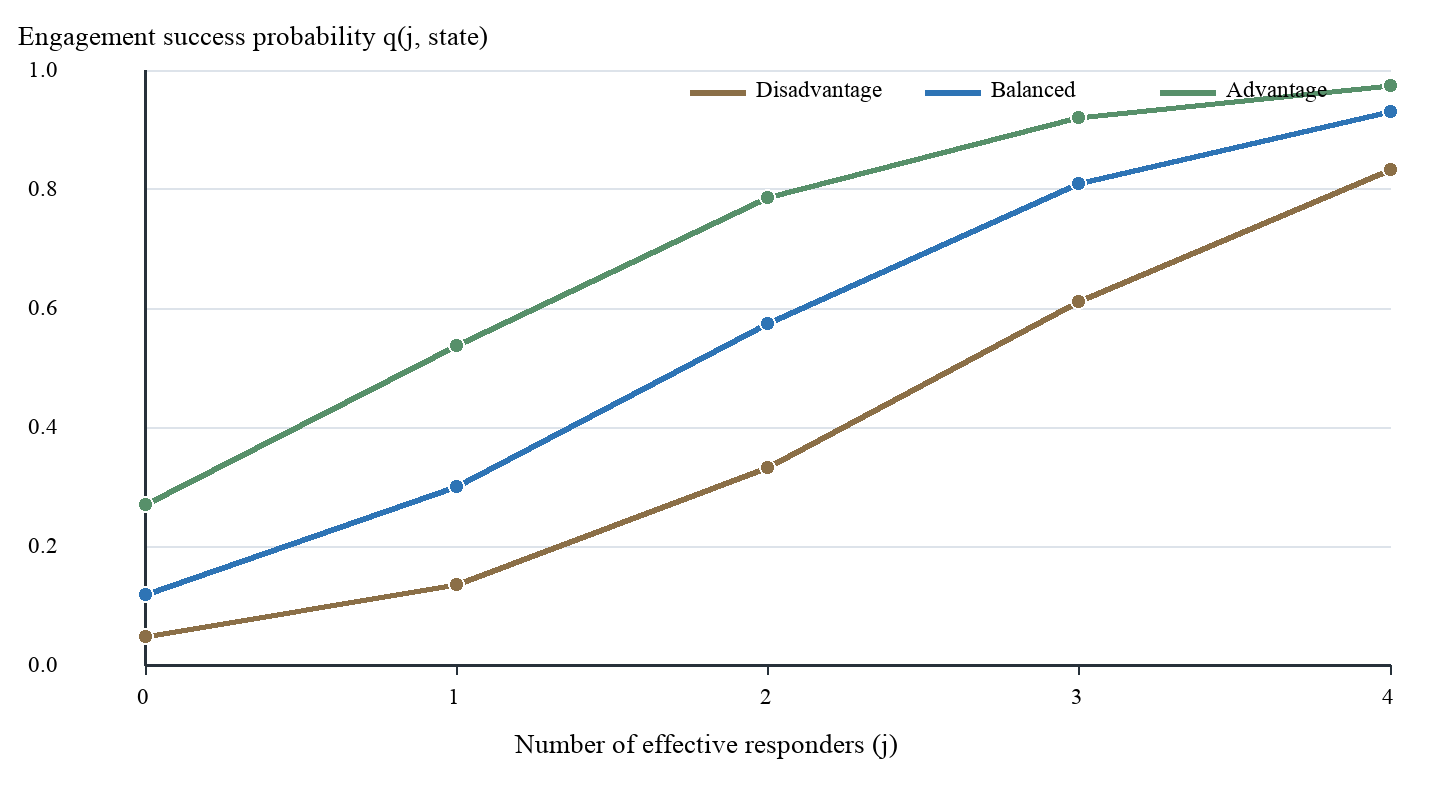
圖1 不同基本面下,響應人數與事件成功機率的示意關係
注:曲線為理論校準示例,不代表真實《王者榮耀》勝率。引數用於展示邊際貢獻隨基本面和響應人數變化。
命題2(先跟的協調乘數)。若式(3)成立,則一名響應者的早期可觀察跟進會提高其他人的最佳跟進機率;當均勢域內存在低響應與高響應多重均衡時,足夠快速且可見的初始跟進會擴大高響應均衡的吸引域。
這解釋了為何先跟不只是個人的路徑選擇,也是均衡選擇裝置。公開轉向、靠近、施放低成本技能或傳送快捷訊號,會先改變其他人的預期,再透過協調乘數提高後續投入。策略建議因此必須區分“先跟的表態與選項保留成本”和“全力承諾成本”。
5 不完全資訊與開團訊號
5.1 貝葉斯更新
現實中θ不可完全觀察。令θ∈{H,L}分別表示有利與不利狀態,先驗Pr(θ=H)=μ。響應者觀察私人訊號sᵢ以及開團動作a_A=1。若高、低狀態下開團機率分別為α_H與α_L,則僅依據開團動作更新後的後驗為:
(5)
當α_H>α_L,開團是正向資訊;當二者相等,開團本身不增加質量判斷;當α_H<α_L,開團甚至可能是負向訊號。但在均勢域內,這些訊號主要用於決定先跟之後要全力承諾、有限支援或退出,而不是用來為原地不動尋找理由。英雄熟練度、此前決策質量與快捷訊號一致性,會改變第二階段的承諾閾值。
結合私人訊號後,i的後驗πᵢ=Pr(H|a_A=1,sᵢ)。若兩狀態下的邊際淨收益分別為g_H(z)與g_L(z),則期望效用差為:
(6)
當g_H(z)>g_L(z),先跟之後是否進一步全力承諾具有後驗閾值:
(7)
式(7)是第二階段判據,而不是第一階段是否起步的判據。更高的關鍵技能可用性、更大的目標價值,以及更多已確認響應的隊友,都會降低全力承諾所需的後驗閾值;敵方增援、反打資源或更高價值的防守任務則會抬高閾值。玩家可以先跟,同時保留不全壓的權利。
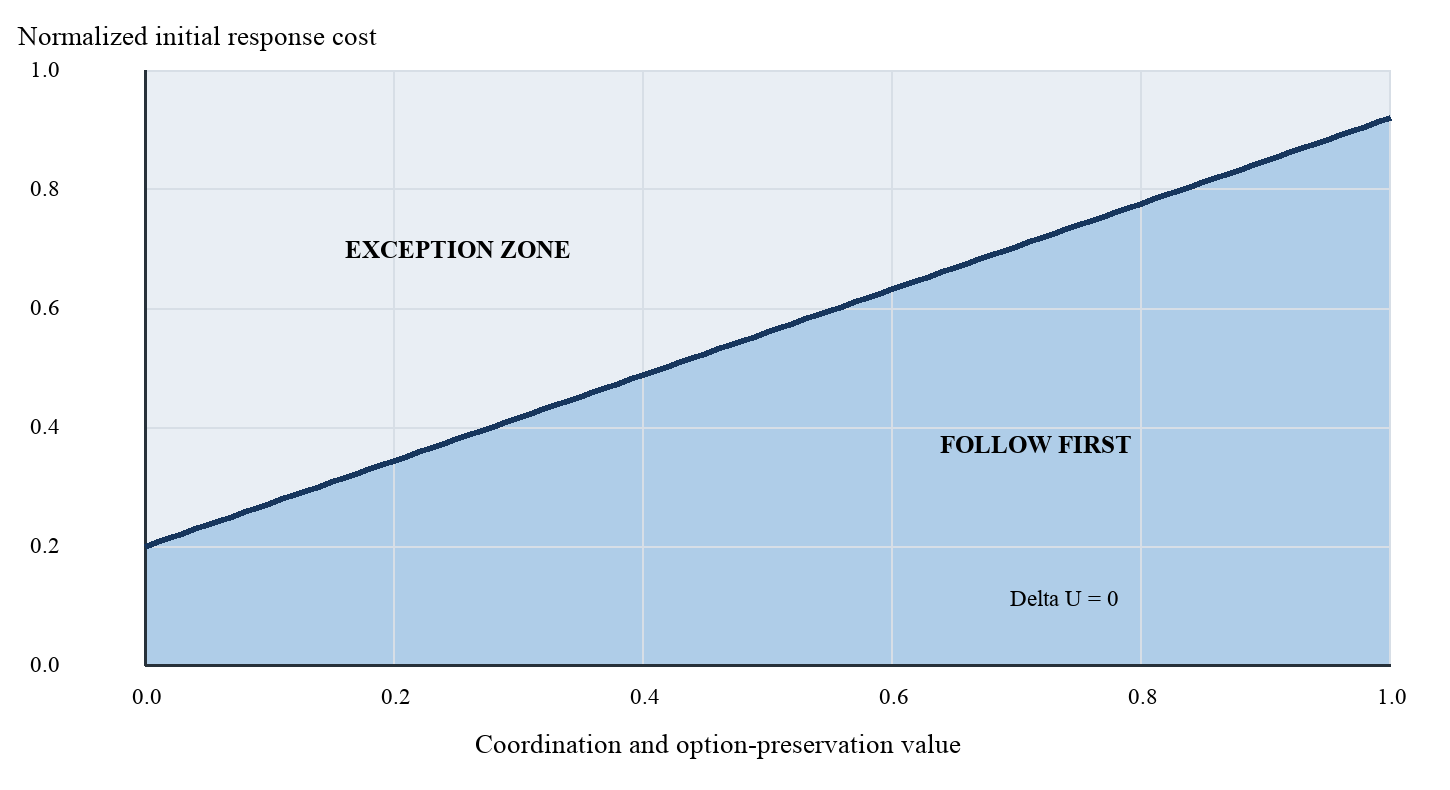
圖2 均勢域內先跟原則的條件邊界
注:橫軸合併選項保留、救援與協調價值,縱軸為初始響應成本;邊界下方為先跟區域,上方為不可達或成本過高的例外域。
5.2 分離、混同與信譽
若高質量型別開團而低質量型別不願承擔失敗成本,行動形成分離均衡,跟隨者可據此大幅上調πᵢ。若所有型別都開團,則形成混同均衡,動作本身不能證明質量。單排匹配的匿名性削弱跨局信譽,但同一局內仍存在短期記錄:此前的高質量訊號、及時撤退和目標判斷會提高後續開團的可信度;連續誤判、無資訊強開或與快捷訊號矛盾則降低可信度。
信譽不是對人的道德評價,而是對其訊號精度的統計估計。理性響應者不應因為一次成功便把α_H/α_L推到極端,也不應因一次失敗完全歸零;更合適的是使用帶收縮的貝葉斯更新,令先驗在樣本很少時佔較大權重。該原則同樣防止“上次他賣我,所以這次我也不跟”的報復性迴圈。
6 響應時延與等待的資訊價值
6.1 有效支援的時間衰減
響應不是瞬時到達。令i在τᵢ秒後生效,單位支援的有效量為wᵢe^(−λτᵢ),其中wᵢ取決於角色與技能。團隊有效支援為:
(8)
λ越大,戰鬥視窗越短。強控制命中後的集火、瀕死隊友的拆火與敵方位移技能真空通常具有高λ;遠端拉扯、陣地消耗和目標區封鎖的λ較低。由此,“猶豫兩秒必然最差”不是普遍真理,但在高λ場景下更可能成立。
6.2 等待作為最優停止問題
等待Δ秒可獲得新資訊y,例如敵方增援、隊友路徑或關鍵技能是否命中。令VOIᵢ(Δ)為資訊帶來的期望決策改進,Dᵢ(Δ)為延遲導致的邊際貢獻下降、救援視窗關閉與被分割風險。若等待還節省誤入成本Sᵢ(Δ),則等待優於立即決策的必要條件可寫為:
(9)
命題3(先跟優於原地等待)。若戰鬥狀態按λ衰減、新資訊到達率有限,且初始跟進不排除後續S或R,則存在臨界衰減率λ*:當λ>λ*時,任何正等待Δ的延遲損失都超過資訊價值,立即先跟嚴格優於原地觀察;當λ≤λ*時,新增資訊可以改變第二階段承諾強度,但只要跟進可回撤,資訊可以在移動與靠近過程中同步獲取。
這一區分正是“先跟、再看”的時間邏輯。玩家不應等到勝負已經明顯才開始移動,因為那時資訊雖準確卻已失去因果作用;也不必在第一秒交出全部資源。均勢域內的正確順序是先保存參與能力,再利用移動途中出現的敵方增援、技能命中和隊友路徑資訊調整承諾。
7 敵方反應與威懾子博弈
先跟原則的另一項價值是:支援者現身會改變敵方追擊收益。令敵方繼續追擊的收益為R,遭反打的預期損失為D(J),且D′(J)>0。敵方選擇追擊當且僅當:
(10)
因此存在威懾閾值J̄,使J≥J̄時敵方撤退。響應者的價值不只來自提高己方正面獲勝機率,還來自跨過J̄後使敵方策略離散改變。若一個低成本前壓即可讓J跨過閾值,有限支援可能嚴格優於全壓:它獲得救援與停止追擊的收益,卻保留位移和關鍵技能。相反,若敵方掌握完整視野且清楚支援者無法輸出,虛張聲勢不會形成可信威懾。
命題4(最小可信支援)。若支援強度x連續、成本c(x)遞增,敵方在J≥J̄時撤退,則在可達條件下,最優威懾支援為使J恰好達到J̄的最小x;超過閾值的額外投入只有在提高後續戰鬥或目標收益時才合理。
8 三元行動擴充套件與可執行策略
8.1 從二元選擇到分級承諾
第一階段完成初始跟進後,第二階段行動集合為Aᵢ={F,S,R}:F為全力承諾,S為有限支援,R為退出/交換資源。三者不是對“要不要理隊友”的重新投票,而是先跟之後的風險分級。F使用關鍵位移與高價值技能並進入敵方主要傷害區;S透過遠端技能、護盾、控制、卡位或可撤回前壓改變局勢;R則在新增資訊明確推翻均勢判斷時止損。
表2 三元響應策略的條件與風險
行動 | 適用條件 | 主要收益 | 主要風險 |
F 全壓 | πᵢ高;邊際傷害/控制關鍵;到場快;已有隊友確認響應 | 跨過勝負臨界點、完成集火併奪取目標 | 團滅、關鍵技能與位置全部暴露 |
S 有限支援 | 正面勝算不確定;可救援或威懾;保有安全退出路徑 | 降低敵方追擊、拆火、延長隊友撤離視窗 | 支援過淺無效;支援過深滑向全壓 |
R 退出/交換 | 跟進途中確認人數或經濟已懸殊;敵方增援;已無有效到場窗口 | 儲存核心資源、避免連續死亡、建立止損線 | 退出過早會放棄可贏團;必須有新資訊支持 |
8.2 決策規則
將模型壓縮成數秒內可執行的順序規則:第一,在開團瞬間只檢查三個門檻——雙方人數是否沒有懸殊、經濟是否沒有懸殊、自己能否在視窗內產生作用。三者成立就立即先跟。第二,在移動、靠近與低成本支援過程中觀察敵方增援、關鍵技能命中、隊友到場與退出路線。第三,若新增資訊維持或改善均勢且自己的邊際貢獻關鍵,升級為F;若正面勝算不明但可救援或威懾,採取S;只有新增資訊明確推翻均勢或已失去作用窗口時才轉R。
表3 “先跟、再判斷”的六步快速規則
快速檢查 | 問題 | 決策含義 |
人數門檻 | 雙方當下與可快速到場的人數是否沒有懸殊? | 是:滿足先跟條件;否:進入例外判斷 |
經濟門檻 | 團隊經濟差是否仍在預設的均勢範圍內? | 是:滿足先跟條件;否:提高止損權重 |
可達門檻 | 我能否在控制鏈或救援視窗結束前產生作用? | 是:立即先跟;否:直接交換資源 |
跟進更新 | 敵方增援、技能命中與隊友路徑是否改變原判斷? | 維持均勢則F/S;推翻均勢才R |
關鍵性 | 我的控制、爆發、保護或承傷是否可能改變結果? | 高:F;中:S;低且有新壞資訊:R |
退出路徑 | 有限支援後能否安全回撤? | 能:S具有選項價值;不能:F與R需更快二選一 |
規範性原則 均勢域內不要先站著判斷,而要先跟著獲取資訊。初始跟進是預設,F/S/R才是跟進途中根據新局勢作出的第二階段選擇。 |
9 重複互動、激勵錯位與有限理性
9.1 局內重複與信譽外部性
同一局內會發生多次團戰,因此單次響應會改變未來信念。令Vᵢ為未來合作價值,δ為折現因子,則當前行動還包含δ·ΔVᵢ。及時但不過度的響應可提高隊友對共同執行的預期;惡意賣隊友或報復性衝鋒會降低未來協調。由於對局有限且終局臨近,純粹依賴長期懲罰維持合作並不穩健;越接近終局,聲譽渠道越弱,當前目標價值渠道越強。
9.2 KDA與排位目標的委託—代理問題
若玩家效用只等於最終勝負,Bᵢ佔主導;若玩家還重視KDA、舉報風險、MVP評價或即時情緒,則效用可寫為Uᵢ=ωUᵢ^win+(1−ω)Uᵢ^private。ω較低時,玩家可能選擇對個人面板安全卻降低團隊勝率的行動。這個偏差不是“非理性”的唯一來源,也可能是評價系統對團隊目標的激勵不完全。實證研究應分別估計勝率導向與私人指標導向的行為,而不能把所有不跟進都解釋為膽怯。
9.3 量化反應與壓力下誤差
在量化反應均衡中,行動a的選擇機率隨預期效用上升:Pr(a)∝exp(κEU(a))。κ表示決策精度;高延遲、資訊擁擠、疲勞或情緒可能降低κ,使劣勢行動仍有正機率。這一框架比“玩家完全理性/完全不理性”的二分更適合解釋單排資料,也能檢驗快捷訊號、介面提示或訓練是否提高決策一致性。
10 比較靜態與可檢驗假設
由式(2)、(3)及(7)至(10)可匯出方向明確的比較靜態。先跟原則的首要異質性來自是否位於均勢域;第二階段F/S/R的差異則由後驗、角色與成本決定。
表4 主要比較靜態
引數變化 | 對F的理論影響 | 機制與異質性 |
位於Θᴮ | 先跟成為預設 | 人數與經濟未懸殊、可達時,選項與協調收益具有正下界 |
Bᵢ上升 | 增加 | 後期高價值目標、兵線與復活時間使事件後果更大 |
cᵢ上升 | 減少 | 核心位無位移、持有關鍵資源或替代目標價值高 |
已有響應z上升 | 臨界區增加,飽和後下降 | 策略互補先增強邊際貢獻,越過拐點後出現冗餘 |
後驗πᵢ上升 | 增加 | 基本面更好或開團訊號更可信 |
人數/經濟差擴大 | 先跟收益下降 | 接近或越過n̄、ḡ後進入例外域 |
時延τᵢ上升 | 減少 | 有效支援按e^(−λτᵢ)衰減,高λ事件更敏感 |
敵方追擊收益R上升 | 威懾更難 | 需要更高J跨過威懾閾值 |
未來折現δ上升 | 取決於信譽效果 | 早中期一致響應的未來合作價值較大 |
H1(均勢域先跟效應):在|ΔN|≤n̄、|ΔG|≤ḡ且可達的事件中,開團後立即轉向戰場相對原地等待,會提高事件價值ΔWP與開團者存活機率。
H2(邊界異質性):先跟的平均效應在人數或經濟差接近均勢域邊界時下降;越過n̄或ḡ後不應假定仍為正。
H3(協調乘數):第一名響應者的早期可觀察跟進會提高其餘響應者在下一秒內轉向戰場的機率,且臨界區效應最大。
H4(時延衰減):在均勢域內,響應時延與事件淨收益呈負相關;控制鏈更短、開團者承傷更高的事件具有更陡負斜率。
H5(兩階段適應性):先跟後根據新增資訊選擇F/S/R,相對“原地等清楚再動”具有更高的期望勝率變化,且不必提高全壓比例。
H6(威懾機制):早期可見支援跨過某一有效強度閾值後,敵方繼續追擊機率非線性下降;只看擊殺會低估先跟的威懾收益。
11 實證研究設計
11.1 資料與分析單位
理想資料是帶時間戳的逐幀遙測:英雄座標、朝向、血量、技能冷卻、視野、傷害、控制、經濟、等級、兵線、野區目標、快捷訊號與擊殺記錄。若無法取得官方遙測,可用高幀率錄影結合計算機視覺與人工雙人編碼建立事件集。分析單位不是整場比賽,而是“玩家—開團事件”;同一事件包含最多四個響應者,並巢狀於玩家、比賽、段位、版本與英雄。
樣本納入標準應在標註前確定:A的開團動作必須可識別;響應者在t₀存活;必須能夠估計其最短到場時間;排除已明確斷線、重連、故意掛機及事件視窗內發生資料缺失的觀察。對“可介入”不應只用直線距離,而應依據移動速度、地形、控制狀態與可用位移計算反事實最早生效時間。
11.2 處理、結果與協變數
表5 實證變數定義
類別 | 變數 | 操作化 |
第一階段處理 | 立即先跟P / 原地等待W | 以t₀後短窗內的轉向、路徑縮短、靠近和低成本技能聯合分類 |
第二階段處理 | 全力F / 有限S / 退出R | 以技能投入、傷害區暴露、救援行動和退出路線聯合分類 |
核心結果 | 事件價值ΔWP | 事件後與事件前模型預測勝率之差 |
短期結果 | 淨經濟、淨擊殺、存活、目標 | t₀後20—60秒多視窗報告,避免只挑最佳視窗 |
機制 | 敵方追擊、控制鏈、救援 | 追擊路徑變化、控制銜接時差、開團者生存機率 |
基本面 | 戰前狀態X | 經濟、等級、血量、冷卻、人數、位置、視野、陣容、兵線與目標 |
異質性 | 角色與時延 | 英雄職能、熟練度、最短到場時間、網路延遲與段位 |
11.3 估計策略與識別限制
最基礎的描述模型可用多項邏輯迴歸估計行動選擇,並以玩家、英雄、版本與段位固定效應吸收穩定差異。對事件結果可估計:
(11)
核心係數是均勢域內立即先跟P相對原地等待W的β_P;β_F與β_S描述先跟後的承諾強度。但這些係數不能自動解釋為因果效果,因為判斷較好的玩家可能同時更早跟進並選到更好的團。建議先以事件前變數訓練兩階段行動傾向模型,再使用交叉擬合的增廣逆機率加權或因果森林估計條件平均處理效應,並將Θᴮ內外分層報告。標準誤至少在比賽層級聚類。
若能利用準實驗變化,可進一步提高識別。例如版本更新改變特定技能的控制持續時間或位移距離,但未同時大幅改變其他屬性時,可構造差分中的差分;然而版本更新往往同時改變英雄選擇與元環境,平行趨勢必須檢驗。網路延遲看似可作工具變數,卻可能直接影響傷害與生存,通常違反排除限制,除非有非常具體的技術性擾動與驗證。
結果變數應優先使用事件後的預測勝率變化而非最終勝負,因為後者噪聲大、受後續無數行動影響。預測勝率模型必須只使用處理前或明確位於結果時點的資訊,防止把處理後變數洩漏進基線。所有視窗、事件定義、排除規則與主要結局應預註冊;探索性分析與驗證性分析分開報告。
11.4 標註可靠性與樣本量
人工標註應對至少20%的事件進行雙盲複核,報告三元行動分類的Cohen κ或Krippendorff α,並對分歧建立裁決規則。樣本量不能按比賽數計算,而應考慮事件內與玩家內相關。正式研究可先用小規模試標估計處理比例、類內相關與結果方差,再根據最小可檢測的ΔWP進行功效分析。若無法達到因果估計所需樣本,應明確定位為預測或描述研究。
12 校準示例與敏感性分析
本節只展示模型如何計算,不報告真實遊戲事實。假設人數與經濟均位於Θᴮ,設Bᵢ=1,Δrᵢ=0.08,三種局部戰術基本面的邏輯引數a分別為−3、−2、−1,β=1.15。第一階段依先跟原則均選擇立即響應;表中毛收益只用於展示第二階段是否升級為全力承諾。
表6 均勢域內“先跟、再分級”的校準示例
基本面 | z | Δq | 毛收益 | 第一階段 | 第二階段示例 |
不利 | 0 | 0.088 | 0.168 | 先跟 | 維持S/必要時R |
不利 | 1 | 0.196 | 0.276 | 先跟 | 升級F |
不利 | 2 | 0.279 | 0.359 | 先跟 | 升級F |
不利 | 3 | 0.221 | 0.301 | 先跟 | 升級F |
均勢 | 0 | 0.180 | 0.260 | 先跟 | 升級F |
均勢 | 1 | 0.275 | 0.355 | 先跟 | 升級F |
均勢 | 2 | 0.236 | 0.316 | 先跟 | 升級F |
均勢 | 3 | 0.121 | 0.201 | 先跟 | 維持S/必要時R |
有利 | 0 | 0.268 | 0.348 | 先跟 | 升級F |
有利 | 1 | 0.248 | 0.328 | 先跟 | 升級F |
有利 | 2 | 0.135 | 0.215 | 先跟 | 維持S/必要時R |
有利 | 3 | 0.053 | 0.133 | 先跟 | 維持S/必要時R |
示例顯示,第一階段是否先跟與第二階段是否全壓是兩個不同問題。在Θᴮ內,玩家先跟以保存到場與協調選項;其後邊際貢獻在臨界區最高,適合升級F,在局部戰術條件較差或投入已飽和時則維持S或依新資訊退出R。這正是本文核心:先跟是均勢域的預設,承諾強度才是動態判斷。
13 討論
13.1 先跟不等於盲目全壓
本文支持的是均勢域內的行動順序,而不是每一波都交出全部資源。先跟把玩家送入仍可影響事件的位置,並同步產生隊友協調和敵方威懾;F/S/R則負責吸收跟進途中出現的新資訊。這種兩階段策略同時避免兩種錯誤:一種是原地評估到來不及,另一種是把初始跟進誤當成不可撤回的自殺承諾。
13.2 先跟原則的例外域
先跟原則不適用於人數已明顯懸殊、經濟差已越過ḡ、玩家物理上無法及時到場、或跟進途中出現敵方大規模增援等狀態。關鍵在於例外必須由可觀察門檻或新增資訊觸發,而不能僅憑“我覺得這團不好”在均勢時預先退出。這使原則既有強制性的預設,又保留可驗證的止損邊界。
13.3 外部效度與倫理
本文以《王者榮耀》式5v5單排為背景,但模型適用於其他臨時團隊的高壓響應:戰術射擊、合作競技乃至分散式應急團隊。外部效度取決於行動時延、角色互補、資訊共享與失敗成本。若使用玩家錄影、聊天或賬戶標識,研究應遵守平臺條款、最小化個人資料並進行匿名化;文字毒性分析尤其不應公開可逆識別資訊。
14 結論
本文把“隊友開團後要不要跟”重構為一個具有明確適用域的兩階段動態協調博弈。當雙方可參戰人數差不多、經濟差不大,且玩家能在有效視窗內到場時,第一階段的理性預設是先跟。其經濟學理由不是服從或情緒,而是先跟能保留後續行動選項、避免不可逆時延,並透過可觀察支援產生協調乘數。
策略互補解釋了為什麼快速、可見的先跟能打破低響應均衡;停止模型說明原地等待會在資訊變準之前先失去作用窗口;訊號與威懾模型則說明先跟途中仍需更新判斷。對玩家而言,最簡潔的原則是:人數不懸殊、經濟不懸殊、能夠到場,就先跟;跟進途中再決定全力承諾、有限支援或退出。
對於研究者,下一步不是繼續用未經驗證的勝率數字論證立場,而是建立可復現的開團事件資料集,預註冊響應視窗與結果指標,並以因果方法區分選擇效應。只有完成這一環節,理論結論才可升級為關於具體遊戲、段位、版本與角色的經驗定律。
參考文獻
Arkes, H. R., & Blumer, C. (1985). The psychology of sunk cost. Organizational Behavior and Human Decision Processes, 35(1), 124–140. https://doi.org/10.1016/0749-5978(85)90049-4
Bernstein, D. S., Givan, R., Immerman, N., & Zilberstein, S. (2002). The complexity of decentralized control of Markov decision processes. Mathematics of Operations Research, 27(4), 819–840. https://doi.org/10.1287/moor.27.4.819.297
Cheng, Z., Yang, Y., Tan, C., Cheng, D., Zhuang, Y., & Cheng, A. (2019). What makes a good team? A large-scale study on the effect of team composition in Honor of Kings. Companion Proceedings of The Web Conference 2019, 266–272. https://doi.org/10.1145/3308558.3313530
Cooper, R., & John, A. (1988). Coordinating coordination failures in Keynesian models. The Quarterly Journal of Economics, 103(3), 441–463. https://doi.org/10.2307/1885539
Freeman, G., & Wohn, D. Y. (2018). Understanding eSports team formation and coordination. Computer Supported Cooperative Work, 27, 1019–1050. https://doi.org/10.1007/s10606-017-9299-4
Harsanyi, J. C. (1967). Games with incomplete information played by ‘Bayesian’ players, I–III: Part I. The basic model. Management Science, 14(3), 159–182. https://doi.org/10.1287/mnsc.14.3.159
Kahn, A. S., & Williams, D. (2016). We’re all in this (game) together: Transactive memory systems, social presence, and team structure in multiplayer online battle arenas. Communication Research, 43(4), 487–517. https://doi.org/10.1177/0093650215617504
Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263–291. https://doi.org/10.2307/1914185
Kou, Y., & Gui, X. (2014). Playing with strangers: Understanding temporary teams in League of Legends. Proceedings of the First ACM SIGCHI Annual Symposium on Computer-Human Interaction in Play, 161–169. https://doi.org/10.1145/2658537.2658538
McKelvey, R. D., & Palfrey, T. R. (1995). Quantal response equilibria for normal form games. Games and Economic Behavior, 10(1), 6–38. https://doi.org/10.1006/game.1995.1023
Morris, S., & Shin, H. S. (2003). Global games: Theory and applications. In M. Dewatripont, L. P. Hansen, & S. J. Turnovsky (Eds.), Advances in Economics and Econometrics: Theory and Applications, Eighth World Congress, Vol. 1 (pp. 56–114). Cambridge University Press. https://doi.org/10.1017/CBO9780511610240.004
Pynadath, D. V., & Tambe, M. (2002). The communicative multiagent team decision problem: Analyzing teamwork theories and models. Journal of Artificial Intelligence Research, 16, 389–423. https://doi.org/10.1613/jair.1024
Sapienza, A., Zeng, Y., Bessi, A., Lerman, K., & Ferrara, E. (2018). Individual performance in team-based online games. Royal Society Open Science, 5(6), 180329. https://doi.org/10.1098/rsos.180329
Schelling, T. C. (1960). The Strategy of Conflict. Harvard University Press.
Suleiman, R., & Rapoport, A. (1992). Provision of step-level public goods with continuous contribution. Journal of Behavioral Decision Making, 5(2), 133–153. https://doi.org/10.1002/bdm.3960050205
附錄A 命題證明
A.1 命題1
定義Mᵢ(z,θ)=Bᵢ[q(z+1,θ)−q(z,θ)]+Δrᵢ(z,θ)。由式(2),ΔUᵢ=Mᵢ−cᵢ。命題假設在均勢域Θᴮ內對所有可行θ與z均有Mᵢ≥cᵢ,因此xᵢ=1的效用不低於xᵢ=0;若至少一個可行狀態滿足Mᵢ>cᵢ,且不存在反向不等式,則先跟在該狀態嚴格較優並在其餘狀態不差。故xᵢ=1在Θᴮ內弱佔優,嚴格條件下為唯一最佳反應。域外狀態不屬於命題主張。證畢。
A.2 命題2
在二元初始響應與有限玩家下,最佳反應由ΔUᵢ的符號決定。式(3)給出遞增差異,故最佳反應隨z弱單調增加。一名玩家的可觀察先跟提高其他人對z的條件期望,沿單調最佳反應對映推動更多玩家轉向戰場;反覆迭代後,高響應均衡的吸引域擴大。這個結果不要求早期玩家立即全力承諾,只要求其初始響應可被觀察。證畢。
A.3 命題3
令原地等待的延遲損失Dᵢ(Δ;λ)連續且對λ嚴格遞增,Dᵢ(0;λ)=0;令資訊淨收益Gᵢ(Δ)=VOIᵢ(Δ)+Sᵢ(Δ)有界。對任意固定Δ>0,存在λ*(Δ)使Dᵢ(Δ;λ*)=Gᵢ(Δ)。當λ>supΔ λ*(Δ)時,對所有正Δ均有Dᵢ>Gᵢ,立即先跟嚴格較優。當λ較低時,若初始跟進不排除後續S或R,玩家可以在移動途中取得同一批資訊,故原地等待只有在跟進本身會不可逆排除更佳行動時才可能較優;該情形屬於命題列明的例外。證畢。
A.4 命題4
若敵方策略在J̄處由追擊離散轉為撤退,且c(x)遞增,則所有使J≥J̄的支援強度獲得相同的純威懾收益。令x*=inf{x:J(x)≥J̄}。任取x>x*,其威懾收益不變而成本更高,故在沒有額外戰鬥收益時被x*嚴格支配。若存在額外收益,則最優x可超過x*,但其理由來自該額外項而非威懾本身。證畢。